


- 集合的框架体系
一、Collection接口 (一)Collection接口实现类的特点
(二)Collection接口遍历元素方式 1、使用迭代器
- collection实现子类可以存放多个元素,每个元素可以是Object
- 有些Collection的实现类,可以存放重复的元素,有些不可以
- Collection的实现类中,有些是有序的(List),有些是无序的(Set)
- Collection接口是通过它的子接口 Set 和 List 来实现的
(1)Iterator对象称为迭代器,主要用于遍历Collection集合中的元素。
(2)所有实现了Collection接口的结合类都有一个iterator()方法,用以 返回一个实现了Iterator接口的对象
(3)Iterator仅用于遍历集合,Iterator本身并不存放对象
- 迭代器的执行原理
Iterator iterator = coll.iterator();//得到一个集合的迭代器
	wihile(iterator.hashNext()){//hasNext():判断是否还有下一个元素
System.out.println(iterator.next());//next()作用:1.下移 2.将下移后集合位置上面的元素返回
}
2、增强for循环
for(元素类型 元素名:集合名或数组名){
			访问元素
}
for (Object obj:col){
		System.out.println(obj);
		}
二、List接口
(一)List接口基本介绍
(二)List接口常用方法1、List接口是Collection接口的子接口
2、List集合类中的元素有序
3、List容器中的元素都对应一个整数型的序号记载其在容器中的位置,可以根据序号存取容器中的元素。
4、
		List list = new ArrayList();
		list.add("张三丰");
		list.add("贾宝玉");
//void add(int index, Object ele):在 index = 1 的位置插入一个对象
		list.add(1,"韩顺平");
//boolean addAll(int index, Collection eles):从index位置开始将eles中的所有元素添加进来
		List list2 = new ArrayList(); list2.add("jack"); list2.add("tom"); list.addAll(1, list2);
//Object get(int index):获取指定 index 位置的元素

// int indexOf(Object obj):返回 obj 在集合中首次出现的位置 System.out.println(list.indexOf("tom"));//2
 // int lastIndexOf(Object obj):返回 obj 在当前集合中末次出现的位置
		list.add("韩顺平");
 		System.out.println("list=" + list);
  		System.out.println(list.lastIndexOf("韩顺平"));
  // Object remove(int index):移除指定 index 位置的元素
 	 	list.remove(0);
  //        Object set(int index, Object ele):设置指定index位置的元素为ele , 相当于是替换.
        list.set(1, "玛丽");
//        List subList(int fromIndex, int toIndex):返回从fromIndex到toIndex位置的子集合
        // 注意返回的子集合 fromIndex <= subList < toIndex
        List returnlist = list.subList(0, 2);
(三)List的三种遍历方式
//方式一:使用iterator
	Iterator.iter = col.iterator();
		while(iter.hasNext()){
		Object o = iter.next();
		}
//方式二:使用增强for
	for(Object o:col){}
//方式三:使用普通for
	for(int i = 0;i < list.size();i++){
	Object obj = list.get(i);
	sout(boj);
	}
	//说明:使用LinkedList完成使用方式和ArratList一样
(四)ArrayList
1. ArrayList的注意事项
(1)ArrayList可以加入(多个)null
(2)ArrayList是由数组来实现数据存储的
(3)ArrayList基本等同于Vector,除了ArrayList是线程不安全的
2. ArrayList底层分析
(1)ArrayList中维护了一个Object类型的数组elementData。
transient Object[ ] elementData;
transient表示瞬间、短暂的,表示该属性不会被序列化
(2)当创建ArrayList对象时,若使用的是无参构造器,则初始elementData容量为0,第一次添加,则扩容elementData为10,再次扩容时为15(10*1.5)
(0-10-10 * 1.5-15 * 1.5…)
(3)若使用的是指定大小的构造器,则第一次添加时elementData容量为指定大小,若需要扩容,则直接扩为原来的1.5倍 (x-1.5x-1.5x * x)
(1)Vector底层也是一个对象数组,protected Object[ ] elementData;
(2)Vector是线程安全的
(3)若使用的是无参构造器,第一次添加时为10,以后按2倍扩容==(0-10-10 * 2)==
(4)若使用的是指定大小的构造器,第一次添加时为指定大小,以后按2倍扩容==(0-x-2x)==
(六)LinkedList 1. LinkedList的全面说明
	(1)LinkedList底层实现了双向链表和双端队列特点
	(2)可以添加任意元素(元素可以重复),包括null
	(3)线程不安全,没有实现同步
2. LinkedList的底层操作机制
(1)LinkedList底层维护了一个双向链表 (2)LinkedList中维护了两个属性 first 和 last 分别指向首节点和尾节点 (3)每个节点(Node对象),里面又维护了 prev、next、item、这三个属性。其中通过 prev 指向前一个,通过 next 指向后一个节点,最终实现双向链表 (4)所以LinkedList的元素的添加和删除不是通过数组完成的,效率较高 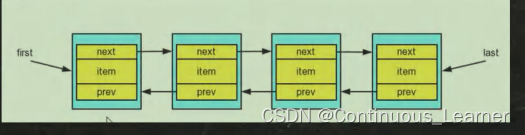3. LinkedList的方法
		LinkedList LinkedList = new LinkedList();
			linkedList.add(1);
			linkedList.add(2);
			linkedList.add(3);
			//删除节点
			linkedList.remove()//默认删除第一个节点
			linkedList.remove(2)//删除第二个节点
			//修改某个节点对象
			linkedList.set(1,999);
			//得到某个节点对象
			Object obj = linkedList.get(1);//得到双向链表的第二个对象

	        //因为LinkedList 是 实现了List接口, 遍历方式
        System.out.println("===LinkeList遍历迭代器====");
        Iterator iterator = linkedList.iterator();
        while (iterator.hasNext()) {
            Object next =  iterator.next();
            System.out.println("next=" + next);

        }

        System.out.println("===LinkeList遍历增强for====");
        for (Object o1 : linkedList) {
            System.out.println("o1=" + o1);
        }
        System.out.println("===LinkeList遍历普通for====");
        for (int i = 0; i < linkedList.size(); i++) {
            System.out.println(linkedList.get(i));
        }
4.ArrayList和LinkedList的比较
三、Set接口 (一)Set接口基本介绍数组是定长的,就是说,数组一旦声明了,长度(容量)就是固定的,不能像某些东西一样伸缩自如。→ ArrayList更适合改查
1. 无序(添加和取出的顺序不一致),没有索引
2. 不允许重复元素,所以最多包含一个null
(二)Set接口的常用方法
和List接口一样,Set接口也是Collection的子接口,因此,常用方法和Collection接口一样(三)Set接口的遍历方式
和Collection的遍历方式一样(因为Set接口是Collection接口的子接口)
1. 迭代器
2. 增强for
3. 注意:不能用索引的方式来获取
4. 集合元素取出的顺序虽然不是添加的顺序,但它是固定的
(四)Set接口实现类——HashSet 1. HashSet的全面说明
(1)HashSet实现了Set接口
(2)HashSet底层是HashMap,HashMap底层是(数组+链表+红黑树)
(3)可以存放null,但只能有一个(不能有重复的元素或对象)
(4)HashSet不保证存放元素的顺序和取出顺序一致
-
HashSet添加元素底层实现方式
  1.添加一个元素时,先得到hash值-会转成索引值
  2.找到存储数据表table,看这个索引位置是否已经存放的有元素
  3.如果没有,直接加入
  4.如果有,调用equals比较,如果相同,就放弃添加,如果不相同,则添加到最后
  5.在JDK8中,如果一条链表的元素个数达到TREEIFY_THRESHOLD(默认是8),
  并且table的大小>=MIN_TREEIFY_CAPACITY(默认64),就会进行树化(红黑树)
-
table数组扩容机制
  1.第一次添加时扩容到16,临界值(threshold)是12(16 * (加载因子loadFactor)0.75)
  2.第二次扩容到32(16 * 2),新的临界值为24(32 * 0.75)
  3.在Java8中,若一条链表的元素个数到达TREEIFY_THRESHOLD(默认是8),
  并且table的大小>=MIN_TREEIFY_CAPACITY(默认64),就会进行树化(红黑树),
  否则仍然采用数组扩容机制
(1) LinkedHashSet是HashSet的子类
(2) LinkedHashSet底层是一个LInkedHashMap,底层维护了一个数组+双向链表
(3)LinkedHashSet根据元素的hashCode值来决定元素的存储位置,同时使用链表维护元素的**次序**,这使得元素看起来是以顺序保存的。
(4) 在LinkedHastSet中维护了一个hash表和双向链表(LinkedHashSet有head和tail)
(5) 每一个节点有pre和next属性,这样可以形成双向链表
(6)在添加一个元素时,先求hash值,再求索引,确定该元素在hashtable的位置,然后将添加的元素加入到双向链表(如果已经存在,不添加【原则和hashset一样】)
(7)这样的话,我们遍历LinkedHashSet也能确保插入顺序和遍历顺序一致
2.LinkedHashSet源码分析
1. LinkedHashSet元素的加入和取出顺序一致
2.LinkedHashSet底层维护的是一个LinkedHashMap(是HashMap的子类)
3. LinkedHashSet底层结构(数组table+双向链表)
4. 添加第一次时,直接将数组table扩容到16,存放的节点类型是LinkedHashMap$Entry类型
(六)TreeSet 1、TreSet的特点
- 当我们使用无参构造器创建TreeSet时,仍然是无序的
- 排序方法
- HW
package Collection;

import java.util.LinkedHashSet;
import java.util.Objects;

//3.58
public class LinkHashSetExercise {
    public static void main(String[] args) {
        LinkedHashSet linkedHashSet = new LinkedHashSet();
        linkedHashSet.add(new Car("奥拓",1000));
        linkedHashSet.add(new Car("奥迪",1000));
        linkedHashSet.add(new Car("奥拓",1000));
        System.out.println(linkedHashSet);
    }
}

class Car{
    private String name;
    private double price;

    public Car(String name, double price) {
        this.name = name;
        this.price = price;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public double getPrice() {
        return price;
    }

    public void setPrice(double price) {
        this.price = price;
    }

    @Override
    public String toString() {
        return "Car{" +
                "name='" + name + ''' +
                ", price=" + price +
                '}';
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        Car car = (Car) o;
        return Double.compare(car.price, price) == 0 &&
                Objects.equals(name, car.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, price);
    }
}
三、Map接口 (一)、HashMap 1、HashMap的特点(JDK8下)
(二)HashMap的常用方法
- Map用于保存具有映射关系的数据:Key-Value
- Map中的key和value可以是任何引用类型的数据,会封装到HashMap$Node对象中
- Map中的key不允许重复,原因和HashSet相同。(当有相同的key时,等价于替换。)
- Map中的value可以重复(key不重复的情况下)
- Map的key可以为null,value也可为null。key为null时不可重复,value则可以。
- 常用String类作为Map的key
- key和value之间存在单项一对一关系,即通过指定的key总能找到对应的value
- Map存放数据的key-value示意图,一对k-v是放在一个HashMap$Node中的。(因为Node实现了Entry接口,有些书上也说一堆k-v就是一个Entry)
(三)Map的六大遍历方式
- put()添加
- remove()根据key删除映射关系
- map.get(key)根据key获取值
- map.size()获取元素个数
- map.isEmpty()判断个数是否为0
- map.clear()清除k-v
- map.containsKey(“key”)查找key是否存在
package rubbish;

import java.util.*;

public class random {
    public static void main(String[] args) {
        Map map = new HashMap();
        map.put("邓超","孙俪");
        map.put("王宝强","马蓉");
        map.put("宋喆", "马蓉");
        map.put("刘令博", null);
        map.put(null, "刘亦菲");
        map.put("鹿晗", "关晓彤");
        //第一组:先取出所有的Key,通过Key取出对应的value
        Set keyset = map.keySet();
        //(1)增强for
        System.out.println("----------第一种方式----------");
        for (Object key : keyset) {
            System.out.println(key + "-" + map.get(key));
        }
        //(2)迭代器
        System.out.println("----------第二种方式----------");
        Iterator iterator = keyset.iterator();
        while (iterator.hasNext()) {
            Object key =  iterator.next();
            System.out.println(key + "-" + map.get(key));
        }

        //第二组:把所有的values取出
        Collection values = map.values();
        //这里可以使用所有的Collections使用的遍历方法
        //(1)增强for
        System.out.println("----------取出所有的value 增强for");
        for (Object value : values) {
            System.out.println(value);
        }
        //(2)迭代器
        System.out.println("----------取出所有的value 迭代器----------");
        Iterator iterator2 = values.iterator();
        while (iterator2.hasNext()) {
            Object value =  iterator2.next();
            System.out.println(value);
        }

        //第三组:通过EntrySet来获取k-v
        Set entrySet = map.entrySet();//EntrySet>
        //(1)增强for
        System.out.println("----------使用EntrySet的for增强(第3种)----------");
        for (Object entry : entrySet) {
            //将entry转成Map.Entry(entry没有getKey()和getValue()方法)
            Map.Entry m = (Map.Entry)entry;
            System.out.println(m.getKey() + "-" + m.getValue());
            //(2)迭代器
            System.out.println("----------使用EntrySet的迭代器(第4种----------)");
            Iterator iterator3 = entrySet.iterator();
            while (iterator3.hasNext()) {
                Object entry =  iterator3.next();
                Map.Entry m = (Map.Entry) entry;
                System.out.println(m.getKey()+"-"+m.getValue());
            }
        }

    }
- HW
package Map;

import java.util.HashMap;
import java.util.Iterator;
import java.util.Map;
import java.util.Set;

public class MapExercise {
    public static void main(String[] args) {
        Map map = new HashMap();
        map.put(01,new Employee("x",1000));
        map.put(02,new Employee("y",2000));
        map.put(03,new Employee("z",19000));
        Set set =  map.entrySet();
        //1.使用keySet-增强for
        Set keySet = map.keySet();
        System.out.println("=======第一种遍历方式=======");
        for (Object key : keySet) {
            //先获取value
            Employee emp = (Employee) map.get(key);
            if(emp.getSalary() > 18000){
                System.out.println(emp);
            }
        }

        //2.使用EntrySet -> 迭代器
        System.out.println("=======第二种遍历方式=======");
        Set entrySet = map.entrySet();
        Iterator iterator = entrySet.iterator();
        while (iterator.hasNext()) {
            Map.Entry entry = (Map.Entry)iterator.next();
            //通过entry取得value ->通过Employ类的getSalary()判断
            Employee emp = (Employee) entry.getValue();
            if(emp.getSalary() > 18000){
                System.out.println(emp);
            }
        }
    }
}

class Employee{
    private String name;
    private int salary;

    public Employee(String name, int salary) {
        this.name = name;
        this.salary = salary;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getSalary() {
        return salary;
    }

    public void setSalary(int salary) {
        this.salary = salary;
    }

    @Override
    public String toString() {
        return "Employee{" +
                "name='" + name + ''' +
                ", salary=" + salary +
                '}';
    }
}
(四)HashMap小结
二、HashTable (一)HashTable的基本介绍
- Map接口的常用实现类:HashMap、Hashtable和Properties
- HashMap是Map接口使用频率最高的实现类
- HashMap是以key-val对的方式来存储数据(HashMap$Node类型)
- key不能重复,但是值可以重复,允许key=null和value=null
- 若添加相同的key,则会覆盖原来的key-val,等同于修改(key不会替换,val会替换)
- 与HashSet一样,不保证映射的顺序,因为底层是以hash表的方式来存储的(HashSet的本质还是HashMap)
- HashMap没有实现同步,因此是线程不安全的(方法没有做同步互斥,没有synchronized )
(二)Properties
- 存放的元素是键值对,即k-v
- hashtable的键和值都不能为null,否则会抛出NullPointerException异常
- hashTable使用方法基本上和HashMap一样
- hashTable是线程安全的,hashMap是不安全的
Collections工具类 一、Collections工具类介绍 (一)Collections是一个操作Set、List和Map等集合的工具类 (二)Collections中提供了一系列静态的方法对集合元素进行排序、查询和修改等操作
- Properties类继承自HashTable类 (key和value不能为空) 并实现了Map接口,使用键值对的形式来保存数据
- 它还可以用于从xxx.properties文件中在家数据到prooerties类对象,并进行读取和修改
- 说明:工作后xxx.properties文件通常作为配置文件,这个知识点会在IO流举例。
- 若添加相同的key,则会覆盖原来的key-val,等同于修改(key不会替换,val会替换)
总结-开发中如何选择集合实现类
- 排序操作(均为static方法)
(1) reverse(List):反转List中的元素的顺序
(2)shuffle(List):对List集合元素进行随机排序
(3)sort(List):根据元素的自然顺序对指定List集合元素按升序排列
(4)sort(List,Comparator):根据指定的Comparator产生的顺序对List集合元素进行排序
(5)swap(List,int,int):将指定list集合中的 i 处元素和 j 处元素进行交换
- 在开发中选择什么集合实现类,主要取决于业务操作特点,然后根据集合实现类特性进行选择,分析如下:



