


- 静态代理:有一个抽象接口,很多个抽象接口的现实类,代理类,一个抽象接口对应一个代理类,如果抽象接口过多,那多对应的代理类也会增加。
- jdk动态代理:有一个抽象接口,很多个抽象接口的现实类,一个jdk代理类,抽象接口过多,也只用jdk代理类,但是只能给实现接口的类做代理。
- 原理:利用实现了InvocationHandler的拦截器+反射机制生成一个实现代理接口的匿名类,在调用具体方法前调用InvokeHandler来处理。
- cglib代理:可以给任何类做代理。
- 原理:基于字节码,ASM字节码处理框架。对代理对象类的class文件加载进来,通过修改其字节码生成子类来处理。主要是对指定的类生成一个子类,覆盖其中的方法,实现增强类,生成的子类因为采用的是继承的方式增强原来的类,对于final类或方法,是无法继承的。
- 选择:
- 如果目标对象实现了接口,默认情况下会采用JDK的动态代理实现AOP。
- 如果目标对象实现了接口,可以强制使用cglib实现AOP。
- 如果目标对象没有实现接口,必须用cglib,spring会自动在JDK动态代理和cglib之间切换。
- SpringApplication调用run方法,run方法里面先实例化SpringApplication对象,SpringApplication里面初始化和加载监听器,通过SPI的方式,在spring.factories文件里,通过不同的k找到多个v,对v进行加载实例化(反射)。
- 实例化SpringApplication以后,调用run方法,会做配置文件的加载,容器的初始化,bean的前置和后置处理。
- SpringBootConfiguration,实际上就是Configuration注解,表示这个类是SpringBoot配置类。
- EnableAutoConfiguration,开启自动配置功能,扫描当前配置类及其子包里面的所有组件扫描到Spring容器中。
- ComponentScan,自定义扫描策略。
- 客户端与数据库服务端建立连接是基于tcp的,每次客户端使用完之后会释放连接。这样每次使用都会重新建立与数据库的连接与释放,比较耗时且浪费不必要的资源。使用连接池,将数据库连接缓存到连接池中,在超时时间内有效,每次使用就不用重新建立连接了。
- Hibernate:全自动,屏蔽了底层的方言,好移植,无需编写sql,省事,但是对于复杂的sql支持比较差,也难以优化,支持一级二级缓存。只需要提供POJO映射关系即可。
- Mybatis:半自动,更加轻量级,可控性更高。可以支持原生的sql语句,方便优化。需要手工匹配提供POJO、SQL、映射关系。
- SqlSession中的对象(四大组件)
- Executor:调度StatementHandler、ParameterHandler、ResultHandler
- SIMPLE:简易执行器,默认
- REUSE:一种执行器重用预处理语句
- BATCH:执行器重用语句和批量更新,针对批量专用的执行器
- StatementHandler:操作句柄
- ParameterHandler:参数处理
- ResultHandler:结果处理
- Executor:调度StatementHandler、ParameterHandler、ResultHandler
- ACID
- 原子性:要么都提交成功要么都失败回滚,不可能只执行其中一部分操作。
- 一致性:从一个一致性状态切换到另一个一致性状态。
- 隔离性:一个事务提交修改之前,另一个事务不可见。
- 持久性:一旦事务提交,该事务所做的修改则会永久性的保存到数据库中。
- 脏读:事务可以读取到另一个事务未提交的数据。
- 不可重复读:读取到另一个事务中提交的update更新的数据。事务A中,两次同样的查询,获取到的结果不同。
- 幻读:读取到另一个事务提交的insert/delete新增的数据。
- 未提交读:脏读现象。
- 提交读(不可重复读):不可重复读现象。(大多数数据库的默认隔离级别,MySql不是)
- 可重复读:解决了不可重复读问题。保证在一个数据中读取的同一条记录相同。(MySql默认)。InnoDB和XtraDB存储引擎通过多版本并发控制MVCC解决了幻读的问题。
- 可串行化:不支持并发了,强制事务串行顺序执行。读取每一行数据都加锁,导致大量的超时和锁争用的问题。
-
理论:
- 相互持有资源并等待对方释放资源。
- InnoDB处理死锁问题:死锁回滚算法,将持有最少行级排他锁的事务进行回滚释放掉,打破环形等待。
-
实操:乐观锁&悲观锁
- mysql8新特性 mysql8读取锁 select for update使用详解
- 乐观锁:版本号,cas
- 悲观锁(排他锁):需要开启事务手动提交,begin、commit
- select * from table_name for update 会等待行锁释放之后,返回查询结果
会话1---
begin;
select * from lu_cloud.sys_operation_log where operation_log_id=1167028235137835009 for update;

加锁成功,并返回查询结果

会话2---
begin;
select * from lu_cloud.sys_operation_log where operation_log_id=1167028235137835009 for update

加锁失败,一直等待

会话1 commit
会话2加锁成功,并返回查询结果
- select * from table_name for update nowait 不等待行锁释放,不返回结果,提示锁冲突 (mysql8)
会话1---
begin;
select * from lu_cloud.sys_operation_log where operation_log_id=1167028235137835009 for update;

加锁成功,并返回查询结果

会话2---
begin;
select * from lu_cloud.sys_operation_log where operation_log_id=1167028235137835009 for update

加锁失败,返回报错信息
Error Code: 3572. Statement aborted because lock(s) could not be acquired immediately and NOWAIT is set.
- select * from t for update skip locked 查询返回查询结果,但忽略有行锁的记录 (mysql8)
会话1---
begin;
select * from lu_cloud.sys_operation_log where operation_log_id=1167028235137835009 for update;

加锁成功,并返回查询结果

会话2---
begin;
select * from lu_cloud.sys_operation_log where operation_log_id in (1167028235137835009, 1167028786189688834) for update skip locked

加锁失败,返回1167028786189688834的记录(没有加锁的记录)
(5)、Spring的事务传播行为
- 事务怎么传播?方法A传播到方法B。Spring解决的就是方法之间的事务传播。
- 事务传播:
- REQUIRED(默认):支持当前事务,如果不存在则创建一个新事务
@Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.REQUIRED)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}

结果:都回滚
解释:testMain申明了事务,testB加入了testMain的事务,因为都处于同一个事务,所以都会回滚

public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.REQUIRED)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}

结果:只有testB回滚
解释:testMain没有申明事务,testB新建一个事务,故只有testB回滚
- SUPPORTS:支持当前事务,如果不存在则以非事务方式执行
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.SUPPORTS)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}

结果:a1,b1入库,b2未入库
解释:因为testMain没有申明事务,所以testB也没事务

@Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.SUPPORTS)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}

结果:全部回滚
解释:因为testMain申明了事务,所以testB加入到testMain的事务
- MANDATORY:支持当前事务,如果不存在则抛出异常。
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.MANDATORY)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}

结果:a1入库,b1,b2未入库
解释:因为testMain没有申明事务,所以执行testB时,方法不会执行,会抛出异常
- REQUIRES_NEW:创建一个新事务,如果存在则暂停当前事务。
Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
    throw Exception;     //发生异常抛出
}
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void testB(){
    B(b1);  //调用B入参b1
    B(b2);  //调用B入参b2
}

结果:a1未入库,b1,b2入库
解释:testB方法内不走事务,testMain走
- NOT_SUPPORTED:以非事务方式执行,如果存在则暂停当前事务。
@Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.NOT_SUPPORTED)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}

结果:a1,b2未入库,b1入库
解释:testMain走事务,testB不走事务
- NEVER:以非事务方式执行,如果存在事务则抛出异常。
@Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
}
@Transactional(propagation = Propagation.NEVER)
public void testB(){
    B(b1);  //调用B入参b1
    B(b2);  //调用B入参b2
}

结果:全部回滚
解释:testMain走事务,testB方法都不会执行,直接抛出异常,由于异常,故a1回滚
- NESTED:如果当前事务存在,则在嵌套事务中执行
@Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    testB();    //调用testB
    throw Exception;     //发生异常抛出
}
@Transactional(propagation = Propagation.NESTED)
public void testB(){
    B(b1);  //调用B入参b1
    B(b2);  //调用B入参b2
}

结果:全部回滚
解释:testMain走事务,testB嵌套事务,即父事务回滚子任务也回滚

@Transactional(propagation = Propagation.REQUIRED)
public void testMain(){
    A(a1);  //调用A入参a1
    try{
        testB();    //调用testB
    }catch(Exception e){

    }
    A(a2);
}
@Transactional(propagation = Propagation.NESTED)
public void testB(){
    B(b1);  //调用B入参b1
    throw Exception;     //发生异常抛出
    B(b2);  //调用B入参b2
}
结果:a1,a2入库,b1,b2回滚
解释:testMain走事务,testB嵌套事务,即父事务回滚子任务也回滚,子事务回滚父事务catch了不会回滚
  -  与REQUIRES_NEW的区别:新建一个事务,且与原事务无关,原事务回滚并不会影响新开启的事务,而NESTED嵌套事务,父事务回滚子事务也回滚
  -  与和REQUIRED的区别:调用方存在事务时,被调用方和调用方使用同一个事务,即在一个事务内,故父回滚子回滚、子回滚父也回滚,若子事务异常了并且父catch子事务,父事务依然回滚;NESTED情况下,若子事务异常了并且父catch子事务,这样只有子事务回滚
(6)、Mysql存储引擎区别?
- MyISAM:索引文件和数据文件是分离的
- InnoDB:数据文件本身就是索引文件。联想—聚集索引
- #缓存区
select @@innodb_buffer_pool_size/1024/1024; 128MB
select @@innodb_buffer_pool_instances; 1个实例 - #数据区
表空间(对应一张表) -> 多组数据区
一组数据区 -> 256个数据区 256MB
一个数据区 -> 64个数据页 1MB
一个数据页: 16kB- 数据页;文件头(38bit) 数据页头(56bit) 最大最小记录(26bit ???) 行数据 空闲区域 文件尾部(8bit) 共计128bit,16B
- 磁盘IO为什么慢?
- 读写磁头在磁盘扇区上读写数据。一次磁盘IO所花费的时间
- 寻道时间: 读写磁头移动到正确的半径上所需要的时间,时间越短,磁盘IO操作越快。3~15ms,一般5ms
- 旋转延迟时间: 找到正确的磁道以后,读写磁头移动到正确的位置上所消耗的时间.一般为磁盘旋转周期的一半。
- 7200转/m -> 120转/s -> 旋转周期1/120s -> 1/240s = 4.17ms
- 数据传输: 将数据从磁盘盘片读取或者写入的时间,一般0.1ms。
- 一次磁盘IO的时间:9.17ms
- 磁盘IO为什么这么慢?
- 磁盘IO: 随机读写,顺序读写
- 1ms = 1000000ns
内存读取一次数据:100ns
一次磁盘IO的时间:9.17 * 1000000ns
9.17 * 10000 倍
- 读写磁头在磁盘扇区上读写数据。一次磁盘IO所花费的时间
- 各个软硬件的读取速度
- CPU 20~20ns 1~32M
- 内存 100ns 32G~96G
- 磁盘 3ms~5ms TB PB
- 索引是按照特定的数据结构把数据表中的数据放在索引文件中,便于快速查找
- 索引是一个文件,存在于磁盘中,占据物理空间。
- 聚集索引
参考- 叶子节点存的是完整的数据
- 数据的物理存放顺序与索引顺序是一致的,即:只要索引是相邻的,那么对应的数据一定也是相邻的存放在磁盘上的。
- 一个表只能有一个聚集索引。数据行和相邻的kv紧凑的存储在一起。
- innodb表,默认将主键作为聚集索引,如果没有定义主键,则选择第一个非空的唯一索引,如果没有非空的唯一索引,则选择rowid作为聚集索引。
- 非聚集索引(B-Tree、哈希等索引)
- 叶子节点存的是字段的值
- 通过索引匹配叶子节点字段的值,再通过索引键值找到表的某行。
- B-Tree&B+Tree索引
'树’原理
- B-Tree:InnoDB中的B-Tree索引底层是用B+Tree实现的。
- 关键字和数据记录是放在一起的。
- 特点:越靠近根节点的数据,查找越快,由于关键字和记录放在一起,而那个节点的容量有限(16K),故随着数据量的增大,性能越来越低,越来越不稳定。
- B+Tree:在B-Tree的基础上改进的。
B+Tree底层原理
B-Tree|B+Tree比较
- 即每个叶节点都包含指向下一个叶节点的指针(链表),方便叶节点范围的遍历。
- 数据记录只存在最底层的叶子节点中,每个记录的查找时间基本一致。
- 特点:由于叶节点存放key和下一节点的指针,而不放记录数据,所以可以容纳的节点数会更多,随着数据量的增大,性能依然稳定。
- 哈希索引
- 针对每一行数据,存储引擎会根据所有的索引列计算出一个哈希值;每行数据一个哈希值,形成一个哈希表,只有精确匹配全部索引行的查询条件才能利用到哈希索引(大话解释:查询的时候,把查询条件利用哈希算法生成一个哈希值,然后去哈希表中匹配,若匹配上,则找出对应的记录,然后比较记录的索引列的值和查询条件的值是否相同,从而避免哈希冲突,若都对应上,说明数据是我们想要的,则返回)。查找速度很快。
- 限制
- 哈希索引中不包含任何列的值,所以无法利用哈希索引避免读取行
- 哈希索引无法用于排序
- 不支持部分索引列匹配查找。必须是使用全部索引列的查询条件才能使用哈希索引。
- 只能支持等值比较,不支持范围查找
- 哈希冲突会影响索引性能。当有哈希冲突时,必须遍历每个哈希值相同的索引项,找到对应的数据行与查询条件去比较,如果完全相同,则数据是我们想要的。
- InnoDB有个功能’自适应哈希索引’:当InnoDB注意到某些索引值使用的非常频繁时,会在B-Tree索引之上再建立一层哈希索引(索引的列就是B-Tree的列),以加快查找效率。
- 空间数据索引R-Tree
- 用于地理数据存储,需要GIS相关函数的支持
- 全文索引
- 用于海量数据的搜索,InnoDB引擎支持
- B-Tree索引、唯一索引、主键索引、普通索引的关系
- B-Tree只是一个底层的算法实现,唯一、主键、普通都是在于此算法上构建的
- 主键索引:数据列不允许重复,不允许NULL,一个表只有一个主键
- 唯一索引:数据列不允许重复,允许NULL,一个表允许多个唯一索引
- 普通索引:没有唯一性限制,允许NULL
LuBlog
- 全值匹配
- 最左前缀,‘keyWord%’
- 范围后面全失效(NOT、!=、<>、!<、!>、NOT EXISTS、NOT IN、NOT LIKE)
- 尽量使用覆盖索引(想要要查询的列,就是索引的key)
- 排序,默认是升序,可以再建立倒序索引
- 使用函数,带null的查询,比较运算,or连接时,索引失效
- 字符串不加单引号,索引失效
- desc 和asc混用时会导致索引失效
参考
- 尝试通过索引去优化,防止索引失效
- 用in代替or,但不要超过200个,否则有性能问题。
- like 模糊匹配,‘xxx%’
- 分页查询
- where条件适当加索引
- left join 第二张表建立索引 查询小表驱动大表
- group by 建议创建索引
- order by 建议创建索引
- join 执行逻辑
- Nested Loop
- Nested Loop Join 双重for循环 A表 -> B表
- Block Nested Loop 缓存Join Buffer 256KB 内存有限 A表 -> Join Buffer -> B表
- Index Nested Loop A表 -> 索引表
- 一次性查询小表的数据放入缓存,然后去大表查询,若大表建立了索引则查询索引页,若无索引则查询数据页
- Nested Loop
- 不建议使用子查询
- MySQL5.5版本,内部执行计划是这样的,先查外表再匹配内表,当外表数据量大的时候,还是很慢,不是我们以为的,先查内表作为条件再去查外表。
- MySQL5.6版本,对这部分做了优化,但只针对select有效对于update/delete子查询无效
- 分组统计可以禁止排序
- 默认情况下,group by col1,col2…会排序。为了避免排序结果的消耗,可以指定order by null禁止排序。
- 禁止不必要的order by排序。默认是索引的顺序。
- 大分页&延迟关联 orderBy执行过程
参考总结
(1)、带来的问题- 分布式事务
- XA协议和两阶段提交处理
- 延长了事务的执行时间,导致事务在访问共享资源时发生冲突与死锁的可能性比较高
- 最终一致性
- 采用事务补偿的方式,例如对数据对账检查。
- 事后同步数据
- 跨节点关联查询join问题
- 全局表:在每个数据库都保存一份一样的数据
- 字段冗余:利用空间换时间
- 数据组装:分多次查询,在代码层面上组装数据
- ER分片:把关联关系的表记录存放在同一个分片上。例如:按照主表主键ID切分。
- 跨节点分也、排序、函数问题
- 现在不同的分片节点中将数据进行范围查询排序并返回,然后将不同分片返回的结果集汇总,再次排序,返回给用户。联想—这点类似于ES的搜索查询机制(索引多分片查询)
- 全局主键重复问题
- 自增长的逐渐肯定会有问题,但是可以控制自增长的初始值,保证他不重复。
- 结合数据库维护主键ID表,在数据库中建立sequence表
有个弊端:太依赖这张表了,如果搞主从的话,数据一致性难以保证。
- 结合数据库维护主键ID表,在数据库中建立sequence表
- 自增长的逐渐肯定会有问题,但是可以控制自增长的初始值,保证他不重复。
--id为自增主键,stub是各个数据库的表名。
--建立此表的目的:给多个库表创建主键id,多少个表多少行数据。
CREATE TABLE `sequence` (
`id` BIGINT ( 20 ) UNSIGNED NOT NULL auto_increment,
`stub` CHAr ( 1 ) NOT NULL DEFAULT '',
PRIMARY KEY ( `id` ),
UNIQUE KEY `stub` ( `stub` )
) ENGINE = MyISAM;

select * from sequence;

--替换当前行数据,为的是让主键递增。
--为啥不用insert into?避免了表行数过大,不需要定期清理小的id。
REPLACe INTO sequence (stub) VALUES ('a');
SELECT LAST_INSERT_ID();

stub字段设置为唯一索引,可以为多张表生成全局ID。
为什么使用MyISAM?表比较简单不需要用InnoDB以获取更高的性能。使用表锁,对表的读写时串行的,不用担心在并发问题。
  - flickr使用一种主键生成策略,借鉴上述方案,并做了优化
     - 思想:建立2个以上的全局ID生成的服务器,每个服务器上都有这个表,更改各个表的主键自增涨步长且起始值错开,就可以将各个表的主键id依次错开。既提高了性能又可以容错。
     - 每次都要查库,很麻烦,怎么优化?一次多取出几个id,放到内存中使用。
A库
auto-increment-offset=1
auto-increment-increment=2
1,3,5,7

B库
auto-increment-offset=2
auto-increment-increment=2
2,4,6,8
- 使用UUID:最简单的方案,本地生成,性能高,没有网络耗时,但是UUID32位有点长,会占用大量的存储空间(索引key空间问题),故导致,主键建立索引和基于索引进行查询时都会存在性能问题,在InnoDB下,UUID的无序性会引起数据位置的频繁变动,导致分页问题(取同一段数据经常有变动)。
- Snowflake分布式自增ID算法
- 组成部分
- 第一位未使用,默认0
- 接下来41位时间戳是毫秒级时间,41位的长度可表示69年的时间
- 5位datacenterId,5位workerId。这10位的长度,可以支持1024个节点
- 最后12位是毫秒内的计数器,可以生成4096个ID序列。
- 好处:毫秒数在高位,生成的ID整体上按照时间趋势递增,不依赖第三方系统,稳定性效率高
- 坏处:依赖于机器时钟
- 组成部分
- 数据迁移、扩容问题
- 数值范围
- 优点:扩容方便,加机器设大小就好。
- 缺点:请求量不均匀,不能负载。例如,新进来的数据利用率比较高,频繁的访问一台机器。
- 数值取模
- 优点:数据量和请求量分布均匀。
- 缺点:扩容麻烦,需要rehash,需要考虑数据平滑迁移。
- 数值范围
- 原理
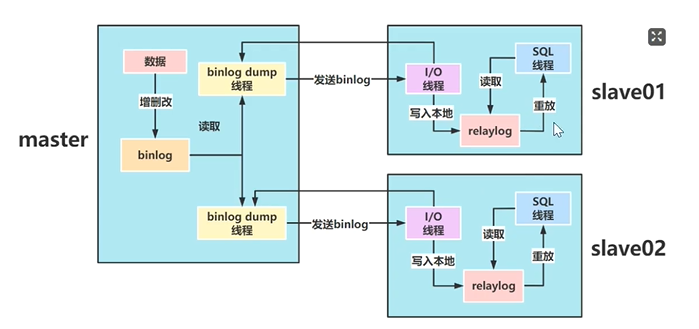
- 几种模式
- 全同步复制
- 当主库执行完一个事务后,要求所有的从库也都必须执行完该事务,才可以返回处理结果给客户端。
- 保证了数据一致性,但主库需要等到所有的从库全部完成,性能较低。
- 异步复制(MySQL默认)
- 当主库提交事务后,会通知binlog dump线程发送binlog日志给从库,一旦全部发送完毕,不需要关心从库是否都处理完毕,主库会将处理结果然会客户端。
- 导致短暂的主从数据不一致问题
- 存在幻读的问题
- 主库处理完事务,发送给从库以后,用户查询可以查询到新增的数据,此时主库挂了,从库未将数据重写完毕,主从切换,从库变为主库,用户读取不到新增的数据,产生幻读现象。
- 半同步复制
- 全同步复制
  - 当主库提交事务后,binlog dump线程向从库发送binlog日志,从库接收到binlog日志,成功写入到relaylog消息后请求响应,只要一个从库这样处理成功了,主库才会将结果返回给客户端
  - 性能,介于全同步复制和异步复制之间;主库等待从库响应的最大时长时刻配置的,如果响应超时,相当于变为了异步复制,产生异步复制的问题。
- 增强半同步(解决半同步带来的影响)
- 主库在存储引擎提交事务前,必须先收到从库数据同步完成的确认消息后,才能提交事务,以此解决。



